이미지와 음성, 영상을 다루는 AI 도구가 최근 두 달 사이 GitHub에 잇따라 공개됐다. 용도를 좁힌 것이 공통점이다. 로고나 포스터의 표현 방식을 정해 주거나, 주제만 넣으면 설명 영상을 만들어 주는 도구가 눈에 띈다. 10개 가운데 여럿은 AI에게 작업 순서를 알려 주는 지침 묶음인 ‘스킬’이고, 음성 모델과 영상 연구 프로젝트도 섞여 있다.
ip-as-logo-skill, 둥근 캐릭터 로고를 만든다
복잡한 묘사를 줄이고 둥근 윤곽을 강조하는 캐릭터 로고 제작용 스킬이다. 배경은 한 가지 색, 구성은 단순하게 잡는다. 브랜드 마스코트 시안을 뽑아 보려는 사람에게 맞는다. 특정 AI 제품에만 쓰도록 묶여 있지 않고, 호환되는 환경이면 쓸 수 있게 만들었다. GitHub 별(이용자가 누르는 관심 표시)은 5,497개다.
이미지: GitHub s1dashu/ip-as-logo-skill (MIT)
mono-color-skill, 적은 색으로 포스터를 만든다
주제나 문장, 사물, 사진을 받아 포스터와 소책자, 포장 등에 쓸 이미지를 만든다. 기본은 중심 색 하나에 강조 색을 조금 더하는 방식이다. 한 가지 색만 쓰라고 요청하면 단색으로 만든다. 색을 절제한 인쇄물 느낌을 원하는 사람에게 맞는다. GitHub 별은 3,264개다.
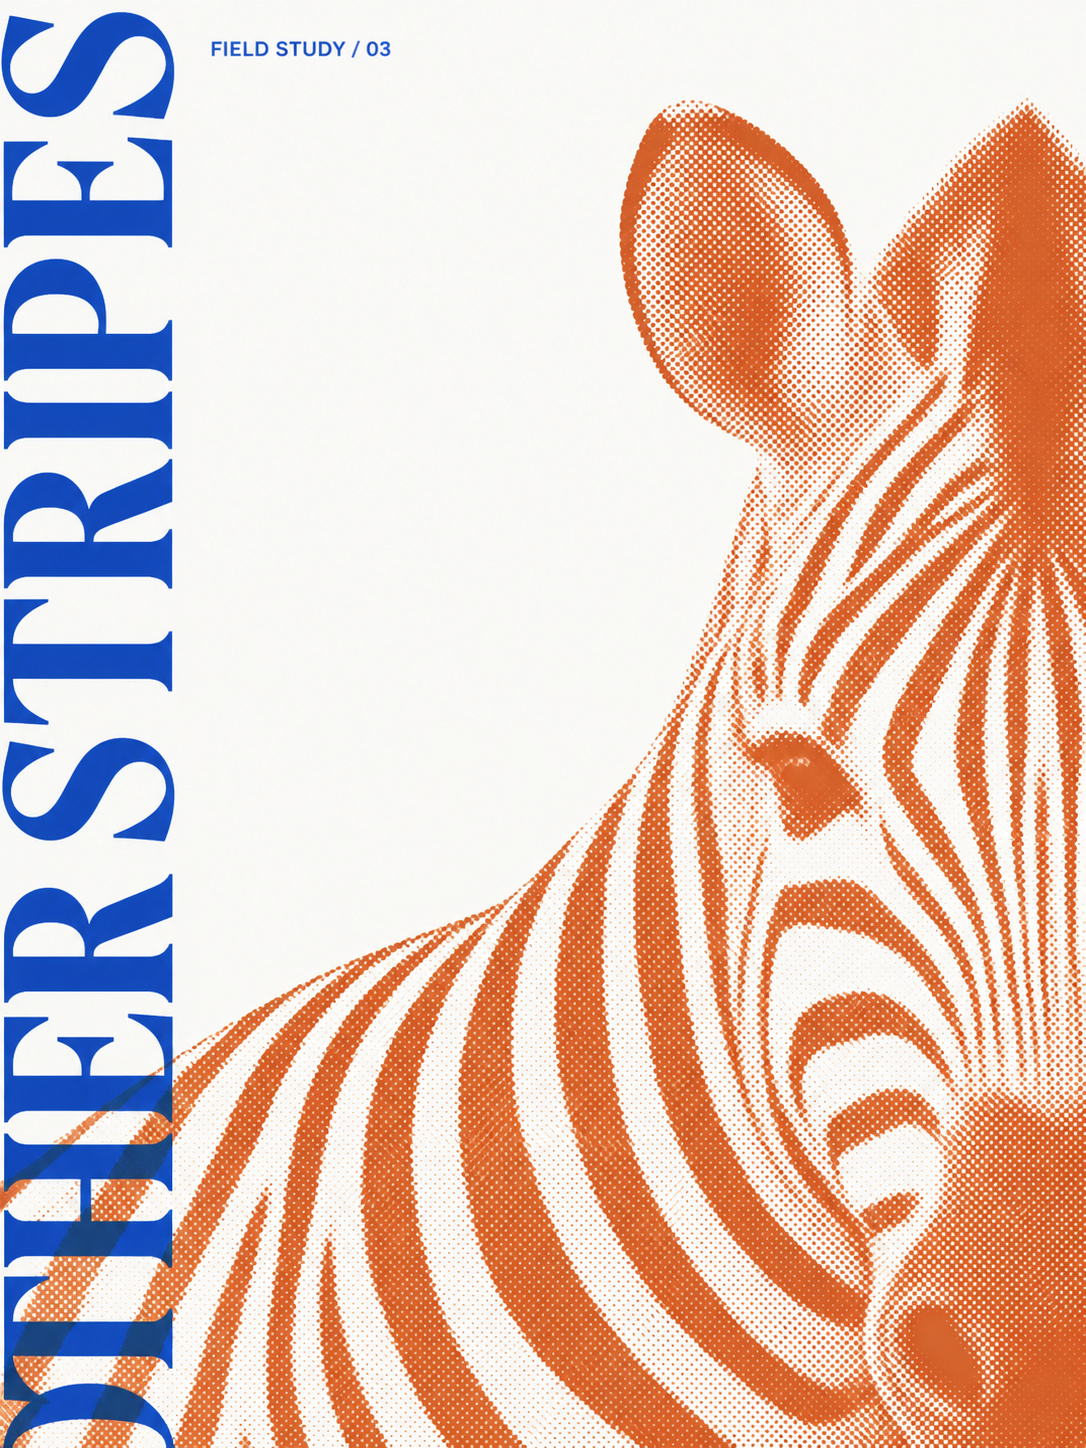
이미지: GitHub yanliudesign/mono-color-skill README (MIT)
qwen-audio-agent, 일하는 중에도 말이 끊기지 않는다
스스로 일을 처리하는 AI(에이전트)에 실시간 음성 대화를 붙이는 도구다. AI가 검색을 하거나 다른 도구를 쓰는 동안에도 대화가 이어지도록 하는 것이 목표다. 음성으로 소통하는 AI 서비스를 만드는 사람을 겨냥했다. GitHub 별은 2,759개다.
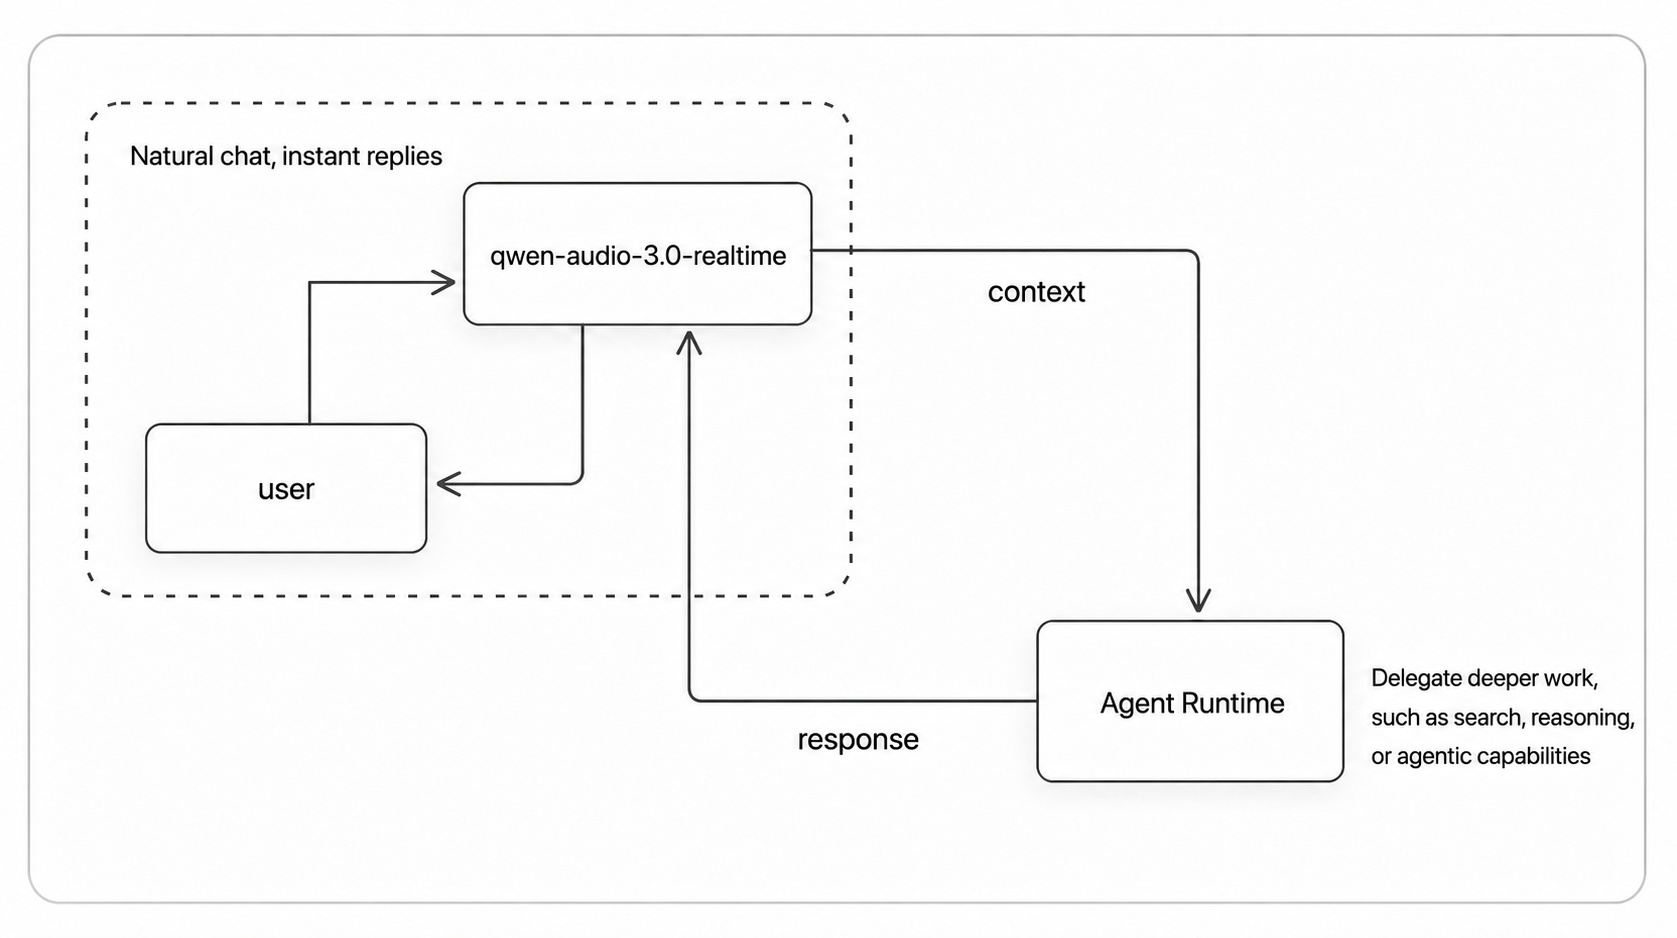
이미지: GitHub QwenAudio/qwen-audio-agent README (Apache-2.0)
anything2explainer, 주제를 해설 영상으로 바꾼다
Claude Code나 Codex에서 주제를 받아 해설 영상을 구성하는 스킬이다. 검은 배경 위에 움직이는 그래픽을 올리고 음성 해설과 자막을 붙인다. 촬영한 영상 대신 프로그램으로 화면을 그린다. 중국어와 영어 설명 영상을 만들려는 사람에게 맞는다. GitHub 별은 2,041개다. 이용 조건은 PolyForm Noncommercial 1.0.0으로, 비상업 이용만 허용한다. 돈을 버는 일에 쓰려면 따로 허가를 받아야 한다.
4DAnyone, 영상 속 인물을 여러 각도에서 본다
카메라 한 대로 찍은 인물 영상을 여러 시점의 영상으로 바꿔 준다. 움직이는 입체 모습을 다시 만들어 내는 후속 작업에 쓰인다. 촬영할 때 카메라를 고정하거나 카메라 정보를 따로 넣지 않아도 된다. 내보낼 수 있는 시점은 수십 개까지다. 9월 16일에는 결과를 화면에서 살펴보고 조작하는 기능도 공개됐다. GitHub 별은 1,376개다.
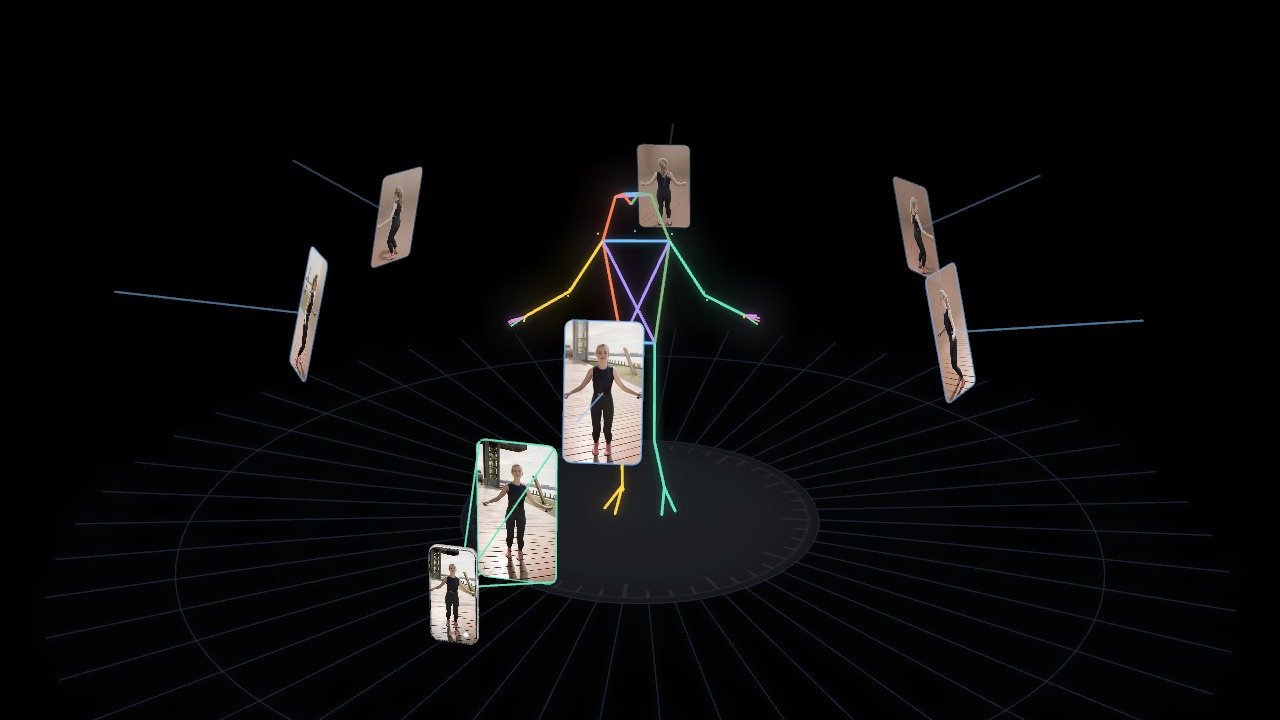
이미지: GitHub ant-research/4DAnyone README (Apache-2.0)
AuK, 음성을 만들고 고친다
음성을 만들고 편집하는 모델이다. 자기 컴퓨터에서 음성 AI를 돌려 보려는 사람이 살펴볼 만하다. 9월 13일에는 애플 자체 칩을 쓰는 컴퓨터에서 모델을 실행하는 기능이 추가됐다. 9월 16일에는 음성을 처리하는 일부 구성 요소의 메모리 사용량을 약 7.5GiB 줄였다고 밝혔다. GitHub 별은 1,252개다. 이용 조건은 비교적 자유로운 MIT 라이선스다. Tencent가 공개한 학습 코드와 실행 코드, 모델 파일에 함께 적용된다.
lanshu-create-ai-presenter-video, 사람이 말하는 영상을 만든다
주제나 대본과 인물 사진을 넣으면 발표자 영상을 만들어 주는 Codex용 스킬이다. 사진은 사용 허가를 받은 성인 사진이어야 한다. 대본 정리부터 음성, 입 모양 맞추기, 자막, 편집과 품질 점검까지 제작 절차를 하나로 묶었다. 특정 업체에 묶이지 않고 실행 환경에서 쓸 수 있는 도구를 골라 쓴다. GitHub 별은 1,016개다.
이미지: GitHub cclank/lanshu-create-ai-presenter-video (MIT)
ComfyUI-H3-Motion-Context, 짧은 영상을 이어 붙인다
이미지와 영상 제작 도구인 ComfyUI에서 MiniMax H3로 만든 짧은 영상을 이어 붙이도록 돕는다. 앞 영상의 마지막 화면과 소리를 다음 영상을 만들 때 넘겨 준다. 그래서 장면이 바뀌어도 움직임과 음성이 이어지도록 설계됐다. 여러 장면을 잇는 영상을 만드는 사람에게 맞는다. GitHub 별은 1,009개다.
이미지: GitHub NikoDemon80/ComfyUI-H3-Motion-Context (GPL-3.0)
travel-photo-abstraction, 사진을 간결한 그림으로 바꾼다
이용자가 준비한 여행 사진이나 일상 사진을 분석하는 Codex용 스킬이다. 형태와 배치, 비율, 색 같은 특징을 뽑아낸다. 이 특징을 적은 수의 시각 요소로 바꿔 간결한 그래픽으로 다시 그려 준다. GitHub 별은 772개다. 이용 조건은 ‘Travel Photo Abstraction Source-Available License 1.0’이다. 받은 그대로 쓰는 것은 허용하지만, 스킬과 문서를 고쳐 다시 배포하는 것은 제한한다.
SolarWM, 긴 영상의 흐름을 다루는 연구 프로젝트
긴 시간에 걸쳐 영상이 어떻게 변하는지 다루는 모델을 목표로 한 연구 프로젝트다. 공개 데이터와 학습 방법을 앞세웠다. 일반 이용자보다는 영상 모델의 학습을 연구하는 사람을 위한 성격이 강하다. GitHub 별은 709개다.
이미지: GitHub Junchao-cs/SolarWM README (Apache-2.0)
써 보기 전에 확인할 것
이번에 모인 도구들은 그림을 만드는 데서 그치지 않는다. 표현 방식을 정하고, 음성을 편집하고, 영상 제작 단계를 이어 붙이는 데 초점을 맞췄다. 별 수는 얼마나 관심을 끌었는지 보여 주는 참고치일 뿐이다. 실제로 쓸 만한지 판단하려면 원하는 결과가 나오는지부터 확인해야 한다. 한국어 지원과 실행 비용도 함께 따져 봐야 한다. 이용 조건은 프로젝트마다 다르니 상업적으로 쓸 계획이라면 미리 살펴보는 것이 좋다.
출처
- s1dashu/ip-as-logo-skill: A compact Agent Skill for highly simplified, rounded, subtly neo-skeuomorphic IP mascot logos.
- yanliudesign/mono-color-skill: One-ink editorial print image skill — warm paper, halftone photography, active negative space, and restrained typography.
- QwenAudio/qwen-audio-agent: A realtime voice runtime that keeps Agents talking, working, and present. Real-time Voice Runtime for AI Agents
- Vincentwei1021/anything2explainer: Topic in, narrated explainer video out. A Claude Code / Codex skill that turns any topic into a black-canvas motion-graphics explainer video with TTS voiceover, subt
- ant-research/4DAnyone: [SIGGRAPH Asia 2026] 4DAnyone: Create Anyone in 4D from a Casual Monocular Video
- Tencent-Hunyuan/AuK: AuK: An Open-Source Foundational Model for Speech Generation and Editing
- cclank/lanshu-create-ai-presenter-video: Provider-neutral Codex Skill for producing verified AI presenter videos from a script and an authorized presenter image.
- NikoDemon80/ComfyUI-H3-Motion-Context: Clip chaining for MiniMax H3 in ComfyUI - motion and audio genuinely continue across joins
- Evianis/travel-photo-abstraction: A source-available Codex skill for distilling photographs into sparse editorial abstractions.
- Junchao-cs/SolarWM: Open data and scalable training for long-horizon video world models.
GitHub 트렌드 다른 기사
내 PC에서 큰 AI 모델 돌린다, 두 달 새 쏟아진 도구들
최근 두 달 사이 공개된 프로젝트들이 PC와 휴대전화에서 AI를 돌리는 방법을 넓히고 있다. 모델을 저장장치에 나눠 두거나 여러 기기에 일을 분담하고, 글쓰기와 음성 명령에도 연결한다.
AI가 영상 만들고 폰까지 조작, 화제의 도구 10개
최근 두 달 사이 공개된 프로젝트들이 AI가 맡을 수 있는 일의 범위를 넓히고 있다. 영상과 스마트폰을 다루는 도구부터 여러 AI에 역할을 나눠 주는 도구까지 모았다.