어떤 AI가 회사 글을 잘 쓸까
회사에서 매일 쓰는 글은 어떤 AI에 맡기면 좋을까. 한국어 업무 글쓰기 세 문제로 여섯 모델을 비교했다. 결과부터 말하면 가벼운 모델도 큰 모델에 뒤지지 않았다. 거래처 메시지 고치기, 공지 요약, 맞춤법 교정에서 사람이 손볼 부분이 얼마나 남는지 살폈다.
업무용 글은 표현이 정중해도 마감일이 흐려지면 곤란하다. 그래서 글을 그럴듯하게 쓰는 능력과 함께 원래 뜻과 요청한 형식을 지키는지도 봤다.
이렇게 시험했다
큰 모델로는 앤트로픽의 Claude Opus 5.5, 오픈AI의 GPT-6 Astra, xAI의 Grok 4.5를 골랐다. Grok 4.5는 xAI의 이전 세대 상위 모델이다. 가벼운 모델로는 앤트로픽의 Claude Haiku 4.5, 오픈AI의 GPT-6 Luna, 구글의 Gemini 3.5 Flash를 비교했다.
시험은 2026년 9월 24일 기본 설정으로 진행했다. 모든 모델에 같은 지시문(프롬프트)을 넣고 문제마다 한 번씩 실행했다. 채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 두 모델은 답변을 쓴 모델 이름을 모르는 상태에서 각각 10점 만점으로 점수를 매겼다. 비교 대상인 Claude Opus 5.5와 채점을 맡은 Claude Opus 5는 다른 모델이다.
정답이 있는 문제는 두 채점 모델이 모두 맞다고 판단해야 통과로 봤다. 표현이 달라도 뜻이 같으면 정답으로 인정했고, 두 모델의 판단이 엇갈리면 판정이 갈린 것으로 처리했다. Gemini 3.5 Flash와 Grok 4.5는 GitHub Copilot으로 실행했다. 실행 경로가 달라 응답 속도를 그대로 맞비교하기는 어렵다.
문제 1: 정중하게 고치되 기한은 지킬까
말투를 부드럽게 바꾸면서도 내일까지 자료가 꼭 필요하다는 뜻을 지키는지 봤다.
아래 메시지를 거래처 담당자에게 보낼 수 있게 정중하고 짧게 고쳐 줘. 원래 뜻(내일까지 자료를 꼭 받아야 한다)은 유지해.

"자료 아직도 안 왔는데요. 내일까지 안 주시면 일정 못 맞춥니다."
이 문제에는 정답 판정이 없다. 점수는 Grok 4.5가 10.0점으로 가장 높았고, GPT-6 Luna가 9.5점으로 뒤를 이었다. Grok 4.5는 인사부터 요청과 맺음까지 네 줄로 정리했다. 핵심인 “내일까지 자료를 꼭 부탁드립니다”도 분명했다. GPT-6 Luna는 두 문장 안에 자료를 기다리는 상황과 기한을 함께 담았다.
짧다고 반드시 좋은 답은 아니었다. GPT-6 Astra는 41자로 가장 짧았지만 아직 자료를 받지 못했다는 맥락이 빠져 7.5점을 받았다. Claude Opus 5.5도 7.5점이었다. 문안 뒤에 대체 표현을 덧붙인 점이 짧게 써 달라는 요청과 맞지 않는다는 평가를 받았다.
Claude Haiku 4.5는 여러 문안과 해설을 한꺼번에 내놓아 6.0점에 그쳤다. Gemini 3.5 Flash는 7.0점을 받았고, “인입”과 “송부” 같은 딱딱한 표현이 지적됐다. 바로 보낼 문장 하나가 필요할 때는 선택지와 설명이 오히려 손볼 일을 늘렸다.
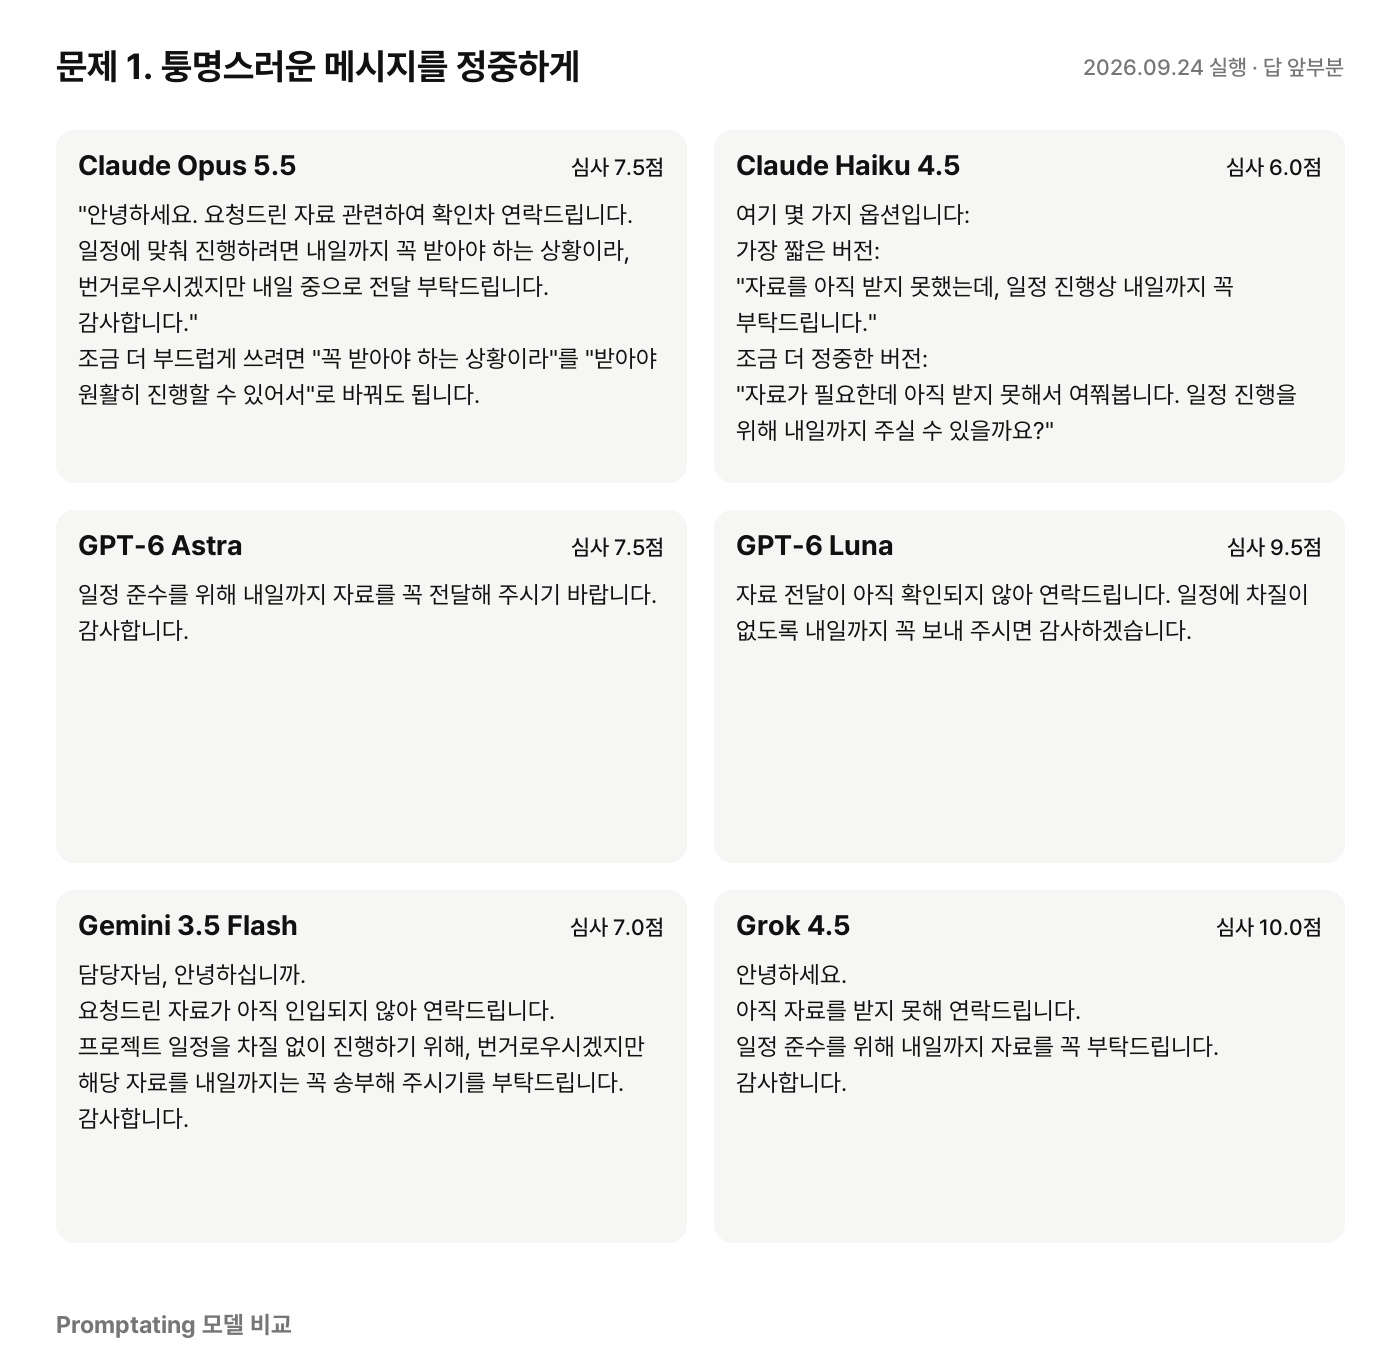
문제 1에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
문제 2: 세 줄 요약, 날짜를 빠뜨릴까
공지의 날짜와 해야 할 일을 빠뜨리지 않으면서 세 줄로 줄일 수 있는지 확인했다.
아래 공지문을 직장인이 30초 안에 읽을 수 있게 세 줄로 요약해 줘. 날짜와 해야 할 일은 빠뜨리지 마.

[공지] 사내 보안 점검 안내
10월 7일(화)부터 10월 9일(목)까지 전 직원 노트북 보안 점검을 실시합니다. 각 팀은 10월 2일(목)까지 팀별 점검 희망 시간을 인사팀 메일로 보내 주십시오. 점검은 1대당 약 20분이 걸리며, 점검 전 개인 파일을 백업해 두시기 바랍니다. 백신이 설치되지 않은 노트북은 점검 당일 업무망 접속이 제한될 수 있습니다.
여섯 모델 모두 정답 기준인 10월 2일, 10월 7일, 백업을 담았다. 정답 판정은 같아도 글의 완성도는 갈렸다. Claude Opus 5.5와 GPT-6 Luna가 나란히 9.5점으로 가장 높았다. 두 모델은 세 줄 안에 점검 일정, 신청 기한, 백업과 주의사항을 정리했다.
GPT-6 Astra는 9.0점으로 제출 방법과 접속 제한 가능성까지 담았다. Grok 4.5는 간결했지만 노트북 한 대당 20분이 걸린다는 정보를 빼 8.5점을 받았다. Gemini 3.5 Flash는 8.0점이었다. 원래 공지의 백신 관련 주의를 설치 완료 지시로 바꾼 점이 지적됐다.
Claude Haiku 4.5는 7.0점이었다. 제목과 빈 줄을 넣어 세 줄이라는 형식을 벗어났다. 접속이 제한될 수 있다는 내용도 “업무망 접속 제한”으로 단정했다. 요약문을 그대로 돌리기 전에는 날짜뿐 아니라 가능성을 확정된 일로 바꾸지 않았는지도 봐야 한다.
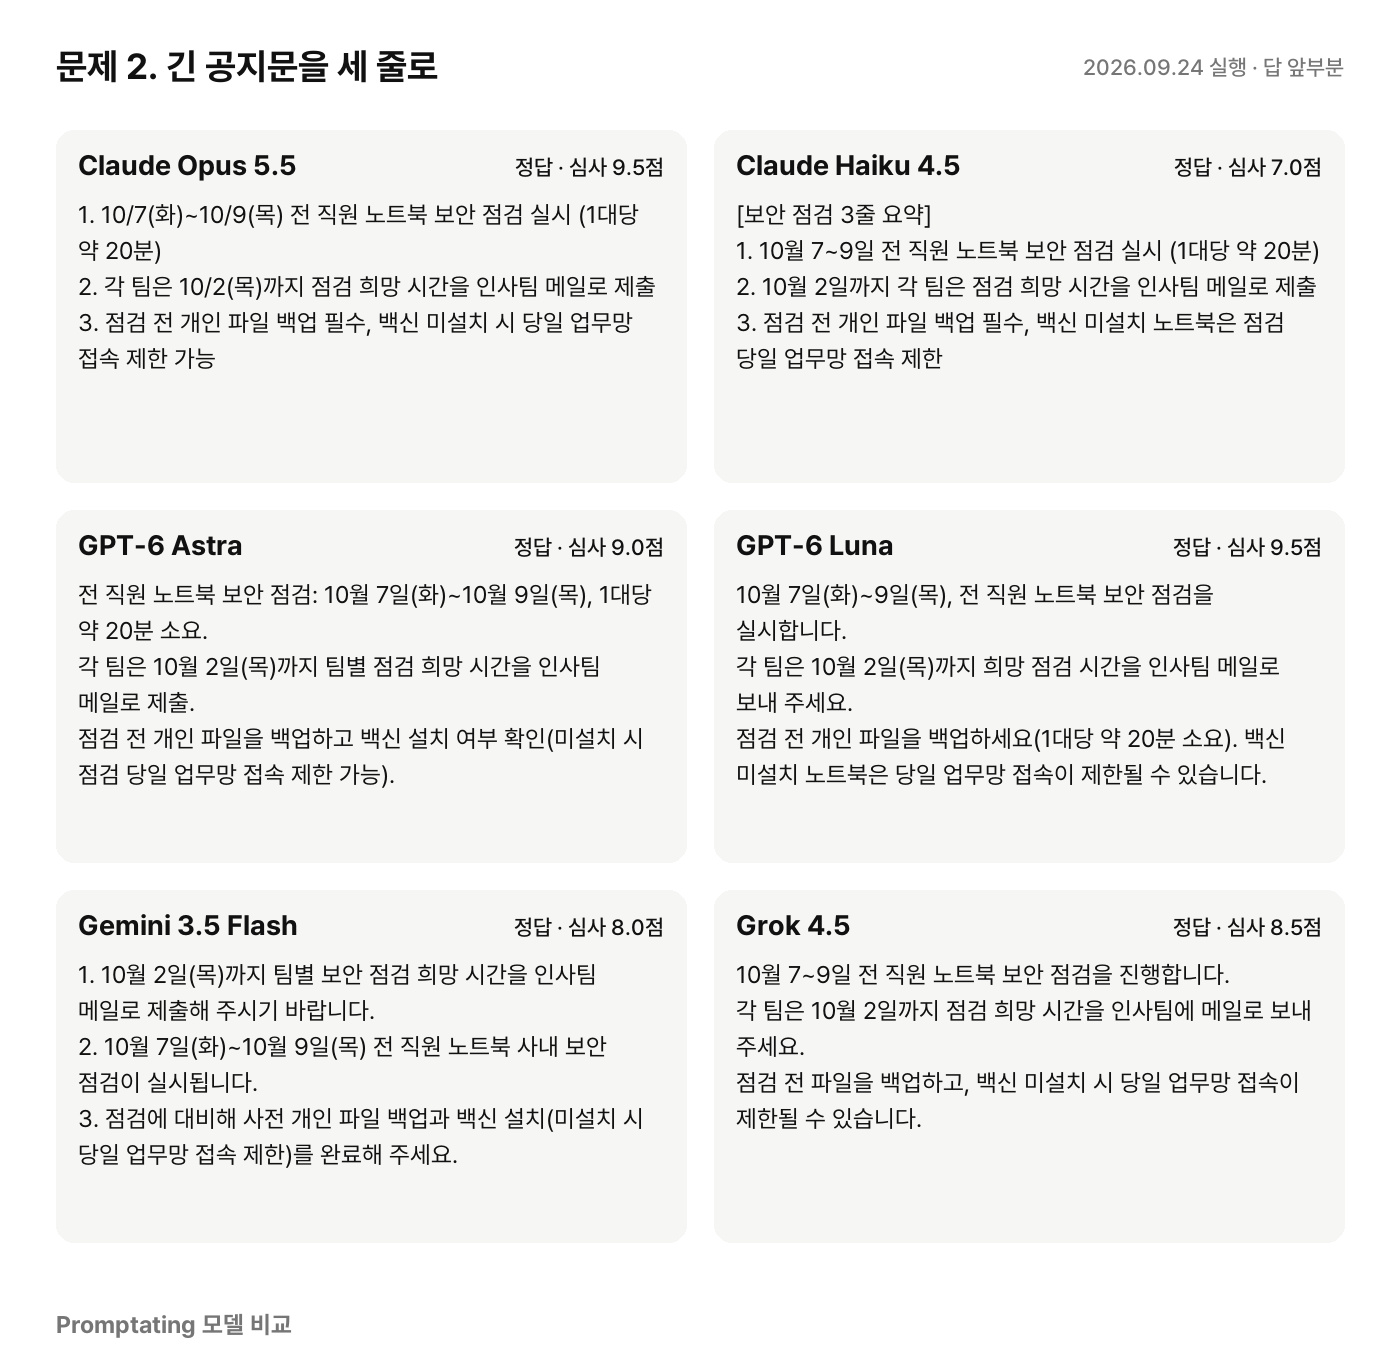
문제 2에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
문제 3: 맞춤법만 고칠 수 있을까
자주 틀리는 표현 세 곳을 바로잡고, 설명 없이 고친 문장만 내놓는지 봤다.
다음 문장의 맞춤법과 띄어쓰기를 고친 문장만 써 줘.

"회의 결과를 않 알려주셔서 몇일 동안 기다렸는데 되도록이면 빨리 연락 부탁 드립니다."
이번에도 여섯 모델 모두 정답이었다. 모두 “안 알려”, “며칠”, “부탁드립니다”에 해당하는 수정을 반영했다. GPT-6 Luna와 Claude Opus 5.5가 쓴 “알려 주셔서”도 올바른 띄어쓰기로 인정됐다.
Claude Opus 5.5는 문장에 따옴표를 남겨 8.5점을 받았고, 나머지는 모두 10.0점이었다. 교정의 정확성은 같았지만 답이 나오는 속도는 달랐다. GPT-6 Luna는 0.6초, Claude Haiku 4.5는 8.0초가 걸렸다. 이 한 문장에서는 오래 기다린 답이 더 정확하지는 않았다.
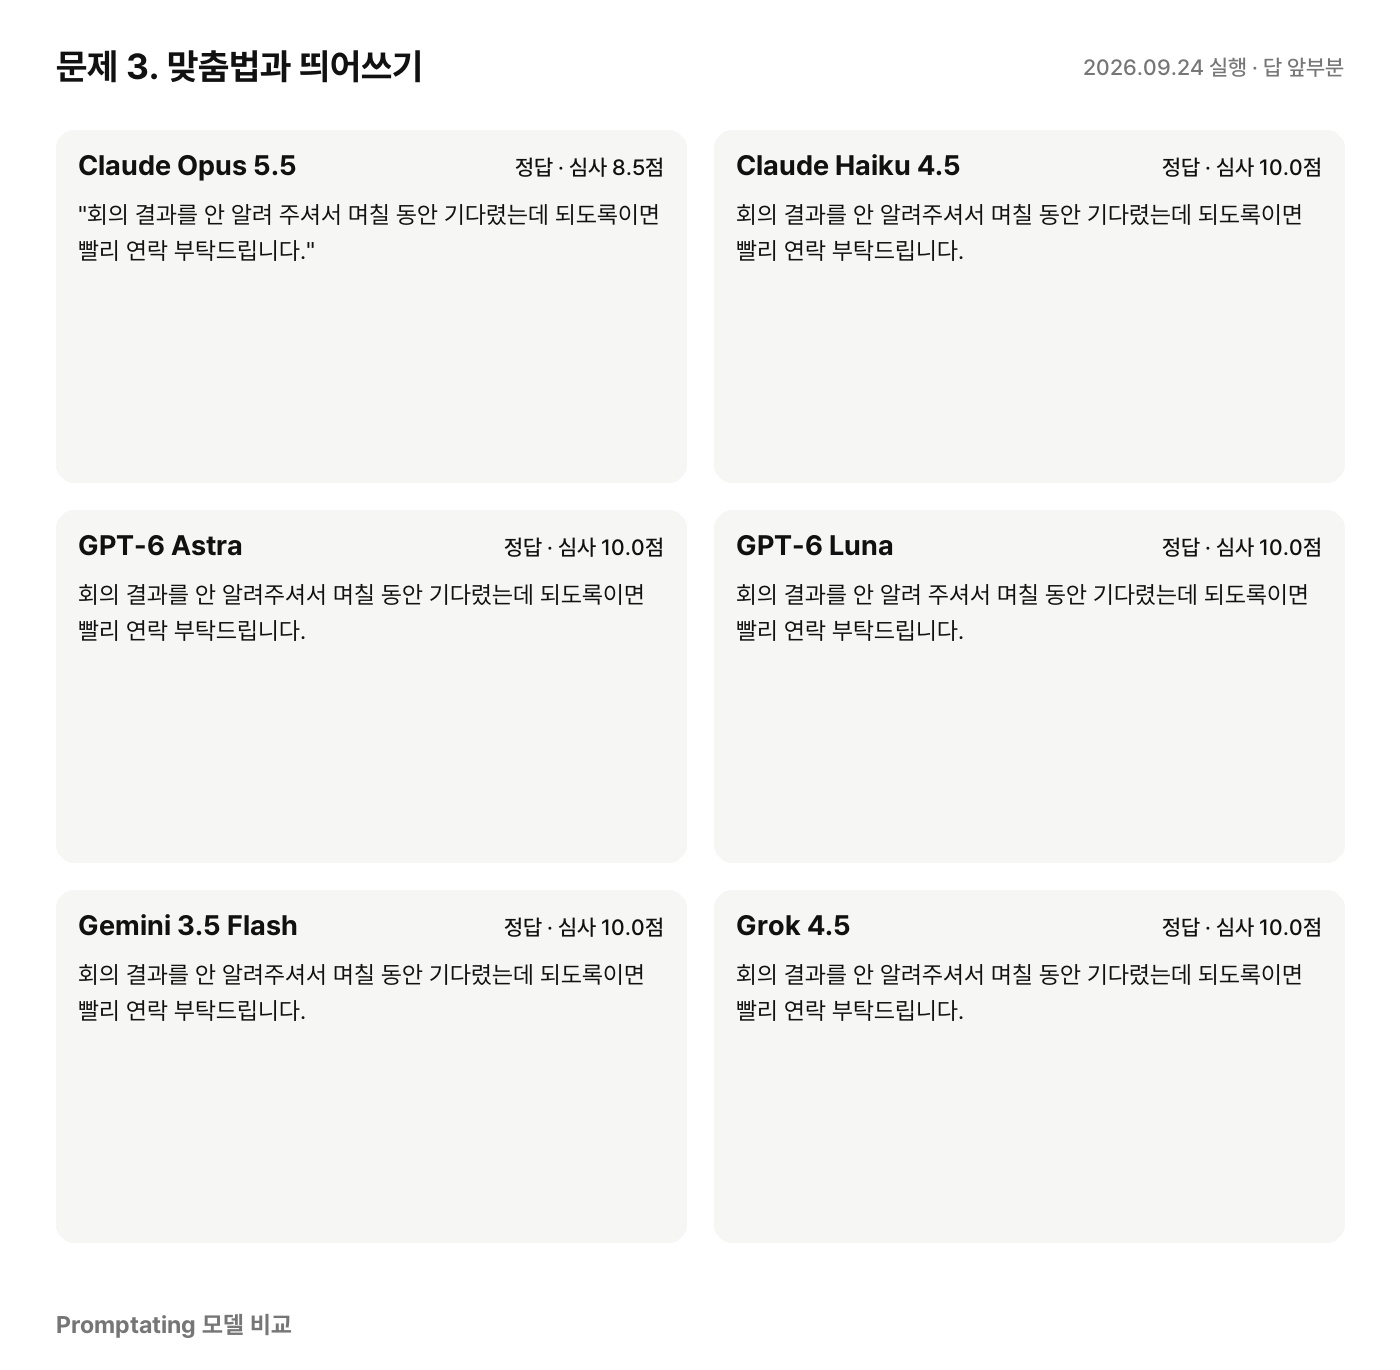
문제 3에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
전체 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| GPT-6 Luna | 9.7점 | 2/2 | 1.2초 | 80자 |
| Grok 4.5 | 9.5점 | 2/2 | 2.5초 | 62자 |
| GPT-6 Astra | 8.8점 | 2/2 | 2.5초 | 29자 |
| Claude Opus 5.5 | 8.5점 | 2/2 | 1.4초 | 88자 |
| Gemini 3.5 Flash | 8.3점 | 2/2 | 1.6초 | 68자 |
| Claude Haiku 4.5 | 7.7점 | 2/2 | 6.0초 | 29자 |
응답 시간은 도구가 준비되는 시간을 뺀 값이다. 실행 경로가 달라 참고용으로만 봐야 한다.
준비 시간은 모델에 OK 한마디를 요청해 미리 쟀다. 출력 속도는 답변 글자 수를 준비 시간을 뺀 응답 시간으로 나눈 값이다. 표의 정답 수는 문제 2와 3만 집계했고, 평균 점수는 세 문제를 모두 반영했다. 글이 빨리 나오는 것과 요청을 잘 지키는 것은 따로 읽어야 한다.
그래서 뭘 쓰면 될까
거래처에 보낼 짧고 정중한 문장을 다듬을 때는 이 문제에서 10.0점을 받은 Grok 4.5가 좋은 선택이었다. 공지를 빠짐없이 세 줄로 줄일 때는 9.5점으로 공동 선두인 Claude Opus 5.5와 GPT-6 Luna가 돋보였다. 빨리 답이 필요할 때는 평균 1.2초 만에 답하고 평균 9.7점을 받은 GPT-6 Luna를 먼저 고려할 만하다.
이번 범위에서는 가벼운 모델로 충분했다. 다만 가벼운 모델이 모두 같은 결과를 낸 것은 아니다. Claude Haiku 4.5는 평균 6.0초로 가장 오래 걸렸고 평균 점수도 7.7점이었다. 큰 모델도 기다린 시간만큼 점수가 높지는 않았다. GPT-6 Astra와 Grok 4.5는 평균 2.5초가 걸렸지만 종합 점수는 GPT-6 Luna보다 낮았다.
이번 비교의 한계
모델마다 문제별로 한 번씩만 실행했고, 문제도 세 개뿐이다. AI가 매긴 점수는 참고 값이다. 정답 기준을 통과했다고 해서 모든 지시를 완벽하게 지켰다는 뜻도 아니다. 이번 결과는 짧은 한국어 업무 글에서는 가벼운 모델도 쓸 만했다는 정도로 읽는 것이 맞다. 여러 번 반복하거나 더 긴 업무 문서를 맡겼을 때도 같은 결과가 나오는지는 앞으로 확인할 점이다.
모델 비교 다른 기사
할인 계산도 일정 잡기도, 가벼운 AI가 모두 맞혔다
Claude Haiku 4.5와 Gemini 3.5 Flash는 세 문제를 모두 맞혔다. 가장 빨랐던 GPT-6 Luna는 두 문제를 틀려, 속도만 보고 고르기는 어려웠다.
상식 문제는 AI 6개 다 맞혔지만, 직장 예절은 갈렸다
AI 모델 6개에 같은 질문 3개를 물었다. 기본 상식과 "모른다"는 답은 가벼운 모델도 잘했지만, 직장 호칭을 설명하는 능력은 모델마다 달랐다.
공부 설명은 GPT-6 Astra, 힌트는 가벼운 모델로도 충분했다
공부 AI 6종을 비교했다. 종합 1위는 GPT-6 Astra였지만, 스스로 풀게 돕는 힌트에서는 가벼운 Gemini 3.5 Flash도 같은 점수를 받았다.